

Con el lanzamiento de cuatro configuraciones en un solo año, la compañía refuerza su infraestructura en la nube y optimiza el rendimiento para cargas de trabajo ultraseguras y ventanas de contexto masivas.
Por: Rodrigo Pujol Del Toro
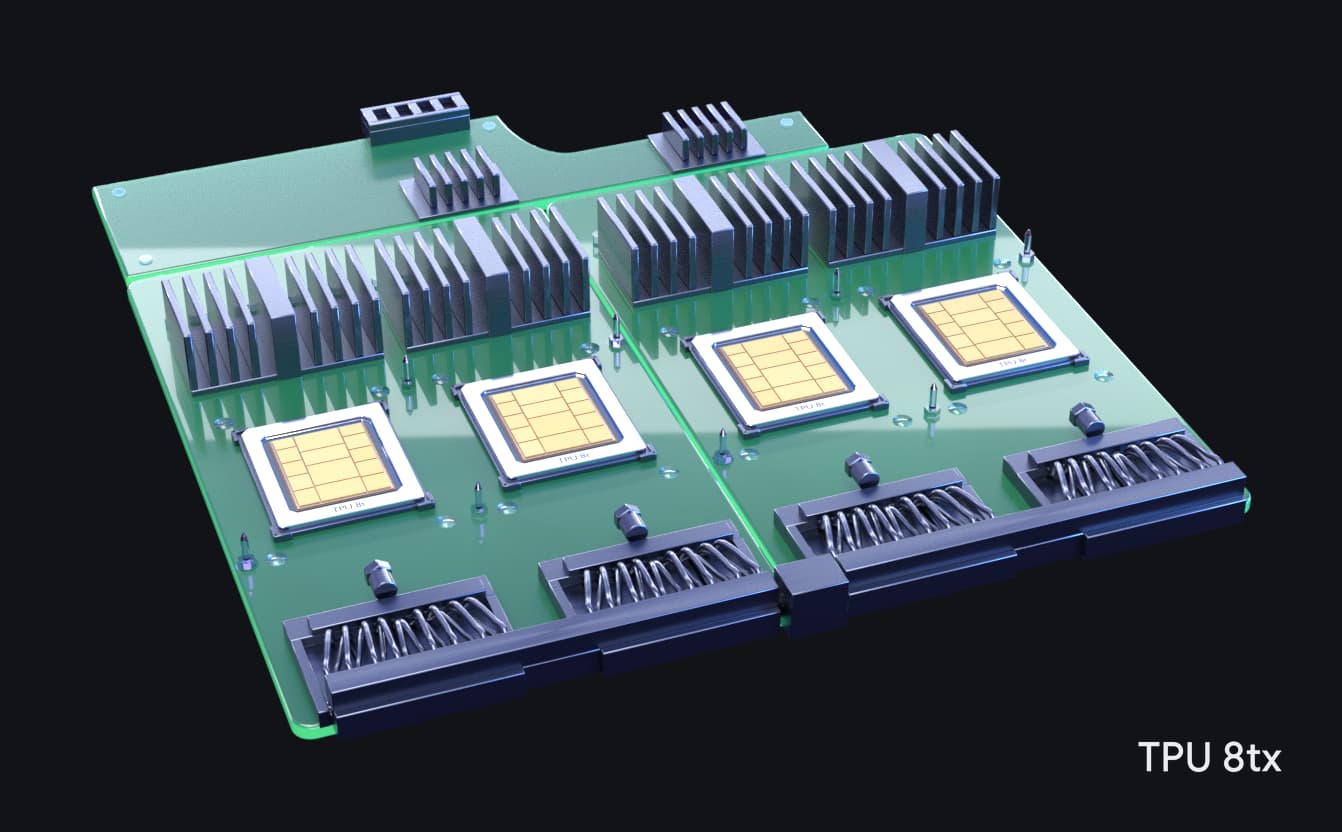
La evolución de la inteligencia artificial hacia modelos basados en agentes autónomos ha transformado las demandas de procesamiento en los centros de datos. Para responder a este escenario, Google anunció la expansión de su portafolio de unidades de procesamiento tensorial (TPU) de octava generación con dos nuevas incorporaciones: el TPU 8tx y el TPU 8i Max.
Con este lanzamiento, que marca la primera ocasión en que la compañía introduce cuatro configuraciones de TPU en un mismo año, Google busca cubrir las distintas etapas del ciclo de vida de la IA, desde el entrenamiento masivo hasta la inferencia segura y el razonamiento de ultra bajo contexto.
TPU 8tx: Computación confidencial y seguridad a nivel de hardware
Diseñado específicamente para organizaciones en sectores altamente regulados y gobiernos, el TPU 8tx integra la seguridad directamente en la capa de silicio. A diferencia de los sistemas tradicionales, donde los datos deben descifrarse en la memoria durante su procesamiento activo, esta arquitectura mantiene la información confidencial y los pesos de los modelos completamente protegidos e isolados.
Combinando el silicio del TPU 8t con hosts de CPU AMD personalizados y una red Boardfly de baja latencia, el sistema permite que los agentes multitarea operen con una latencia reducida a la mitad. Además, su capacidad híbrida posibilita que las empresas ajusten modelos, entrenen agentes mediante aprendizaje por refuerzo y ejecuten cargas confidenciales en un único sistema, sin necesidad de migrar datos sensibles entre diferentes clústeres.
TPU 8i Max: Superando el muro de memoria
Cuando múltiples agentes de IA operan de forma simultánea sobre volúmenes masivos de información —como bases de código completas o horas de video—, el ancho de banda de la memoria se convierte en el principal cuello de botella.
Para resolver este desafío, el TPU 8i Max integra dos chips TPU 8i en un único encapsulado, duplicando la capacidad de cómputo, la memoria SRAM y el ancho de banda HBM. Este diseño escala el rendimiento de forma sincronizada y duplica la densidad de procesamiento por rack, permitiendo a los centros de datos gestionar contextos de hasta un millón de tokens con máxima eficiencia energética.
“A medida que la computación evoluciona de una escala centrada en el ser humano a una escala basada en agentes, las empresas demandan aceleradores capaces de razonar a través de las enormes ventanas de contexto de los modelos de IA”, señaló Amin Vahdat, Chief Technologist and Senior Vice President for AI and Infrastructure at Google.

Con esta familia de cuatro aceleradores —compuesta por el TPU 8t para entrenamiento a gran escala, el TPU 8i para razonamiento, el TPU 8tx para computación confidencial y el TPU 8i Max para contextos masivos—, Google consolida una infraestructura abierta y personalizada para impulsar la siguiente generación de aplicaciones inteligentes.
Nota del editor: La verdadera revolución de la inteligencia artificial ya no ocurre solo en los algoritmos, sino en el silicio avanzado que hace posible procesar el pensamiento y la seguridad a una escala sin precedentes.
Para contactar al editor escribe: editor@thunder.mx.
#GoogleTPU #InteligenciaArtificial #CloudComputing #InfraestructuraIA #GoogleCloud #HardwareDeIA #Tecnologia2026 #InnovacionTecnologica #AgentesDeIA

